
Introduction
Cette note présente les hypothèses, la méthodologie et les limites associées aux données de projection d’emploi. Elles estiment le nombre d’emplois par Zone d’Analyse en Transport (ZAT) pour les années 2021, 2026, 2031, 2036 et 2041. Les projections sont probabilistes et basées sur un modèle statistique tendanciel. Elles seront révisées après la publication des données du recensement 2026.
La réalisation du modèle de prédiction des emplois repose sur un projet de recherche financé par l’ARTM et en collaboration avec les professeurs Cédric Brunelle (professeur en économie urbaine à l’Institut National de la Recherche Scientifique) et Jean Dubé (professeur en économie à l’Université Laval). Un rapport final de ce projet de recherche est disponible en annexe et donne davantage de détails sur le cadre théorique autour du modèle ainsi que la structuration des données. Ce projet de recherche s’inscrit dans le cadre du renouvellement des outils de modélisation de l’ARTM, ces données de projection d’emploi ont donc été conçues avant tout pour servir d’intrant au nouveau modèle méso des déplacements de la région de Montréal de l’ARTM.
Conseil d’interprétation
Les projections sont des estimations probabilistes. Utilisez-les avec prudence, en tenant compte des hypothèses et des limites mentionnées ci-dessous.
Hypothèses et limites
- Les projections supposent la continuité des tendances historiques observées entre 1996 et 2016.
- Les changements futurs d’occupation du sol ne sont pas pris en compte (car absence de données projetées).
- Les données de 2021 sont exclues du modèle en raison du biais lié à la pandémie (travail à domicile).
- Certaines ZAT très petites sont absentes des projections en raison de contraintes d’estimation.
- Compte tenu de la forte variabilité du nombre d’emplois par ZAT, il convient d’utiliser ces données avec prudence et un certain regard critique.
Données sources
La principale source de données utilisée provient de Statistique Canada. Il s’agit des données des profils de recensement à l’échelle des Aires de Diffusion (AD). Ces données ont été filtrées pour ne conserver que les travailleurs ayant un lieu habituel de travail (y compris le domicile) et pivotées selon le lieu de travail. Ainsi, pour les années de recensement 1996, 2001, 2006, 2011 et 2016, nous disposons d’une estimation du nombre de travailleurs par AD. Ce nombre de travailleurs est utilisé comme un proxy du nombre d’emplois. Notez que cette estimation ne recouvre donc que les emplois occupés et les emplois ayant un lieu fixe de travail. Pour l’usage en modélisation des déplacements, cette estimation du nombre d’emplois est pertinente, car elle représente principalement la localisation des emplois qui vont nécessiter des déplacements.
Les données de 2021 n’ont pas été incluses, car elles ont été collectées pendant un confinement lors de la pandémie de COVID-19. La question sur le lieu habituel de travail est fortement biaisée par de nombreux répondants ayant déclaré leur domicile. Nos analyses préliminaires de ces données ont révélé des réductions anormales des densités d’emploi dans les quartiers centraux alors que les volumes d’emplois régionaux restaient cohérents.
Considérant la variation de la géographie des AD et les besoins de modélisation de l’ARTM, un exercice d’interpolation spatiale a été réalisé pour transférer les emplois des AD des différentes années vers la géométrie des ZAT (constante dans le temps). Ce travail d’interpolation est détaillé dans le rapport annexe. Précisons simplement qu’il croise des données du rôle foncier (Cadastre des Unités de Base Foncier) avec des données d’un modèle numérique d’élévation pour dériver des surfaces de planchers pour les différentes années. Ces surfaces servent de variables auxiliaires dans un exercice de Dasymetric Mapping permettant de passer des AD aux ZAT. Pour plus de détails, se référer aux sections 4.1.1 et 4.1.2 du rapport en annexe.
Pour chaque ZAT, un ensemble de variables indépendantes ont été construites afin de prédire le volume d’emploi pour chacune des années. Ces variables ont été produites à partir de sources variées de données incluant : le rôle foncier (MAMH), la banque de données cadastrale du Québec (MERN), le réseau routier (Statistique Canada), et les données d’établissements et noms d’entreprise (REQ). Pour plus de détails, se référer à la section 4.2 du rapport en annexe.
Formulation du modèle
Le modèle de projection final utilisé par l’ARTM diffère de celui présenté dans le rapport en annexe. Les deux modèles partagent de nombreuses similitudes, notamment dans leur intégration des effets fixes. Plusieurs améliorations ont été apportées au modèle développé pendant l’entente de recherche pour en améliorer la capacité de prédiction et la robustesse aux valeurs aberrantes.
Le modèle de projection est donc un modèle de régression Distributionnelle Généralisé Additif à effets Mixtes (DGAMM). La formulation complète du modèle est proposée ci-dessous.
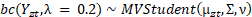
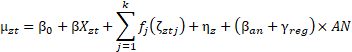
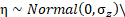
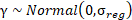
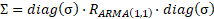
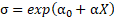
Nous détaillons ci-dessous les différentes composantes du modèle :
- Le modèle ne modélise pas directement le volume d’emploi (Y), mais plutôt le volume d’emploi transformé avec la fonction BoxCox (λ = 0.2, déterminé par minimisation du RMSE). Une loi de Student multivariée est utilisée pour intégrer la dépendance temporelle entre les observations d’une même ZAT et offrir une estimation robuste aux valeurs extrêmes.
- La moyenne attendue du nombre d’emplois pour une ZAT est conditionnée par plusieurs effets fixes dont :
- La surface de plancher associée à l’activité commerciale
- La surface de plancher associée à l’activité manufacturière
- La surface de plancher associée à l’activité transport
- Le nombre de bâtiments avec plus de 10 étages
- Le nombre de kilomètres d’autoroute
- La part de la superficie étant agricole
- La présence d’un pôle majeur
- La présence d’un hôpital majeur
- Le nombre de stations de métro
- Le nombre de stations de train
Une partie de ces effets fixes sont ajoutés comme des variables non linéaires pour capturer des effets de seuils (smoothing splines et effets monotoniques).
- La moyenne attendue du nombre d’emplois varie aussi selon deux effets aléatoires, structurés au niveau des ZAT et des régions (Montréal Centre, Est, Ouest, Laval, Longueuil, Couronne Nord, Couronne Sud). Cet effet aléatoire permet de tenir compte du fait que certaines ZAT et régions comptent structurellement plus d’emplois que d’autres. L’effet aléatoire permet une estimation par partial pooling limitant la taille de cet effet, contrairement à l’estimation par effets fixes.
- La dimension temporelle est incluse à plusieurs niveaux dans le modèle.
- Premièrement, l’année (1996, 2001, 2006, etc.) est incluse comme un effet fixe dans le modèle, permettant de capturer une tendance générale à la croissance ou décroissance de l’emploi. Ensuite, cet effet est modulé par super-ZAT (regroupement de ZAT) avec un coefficient aléatoire. Deux modèles sont réalisés, le premier inclut le pas de temps directement, alors que le second l’inclut avec une transformation log. Ces deux spécifications supposent soit une tendance de croissance linéaire, soit une tendance de croissance logarithmique (de moins en moins rapide). Les prédictions des deux modèles sont combinées dans les prédictions finales par moyenne bayésienne.
- Deuxièmement, la variance (erreur) de la distribution de Student est modélisée par un terme ARMA d’ordre 1. Ce terme permet de tenir compte de l’autocorrélation temporelle à l’échelle des ZAT. Cependant, le faible nombre d’époques dans les données (5 époques entre 1996 et 2016) rend difficile la prise en compte de cet effet.
- La variance de la distribution de Student est autorisée à varier selon la région, représentant le fait que le volume d’emploi a tendance à être plus variable dans certaines régions.
Le modèle a été estimé avec une méthode bayésienne. Les a priori bayésiens intégrés au modèle sont peu informatifs et avaient seulement un rôle de régularisation pour certains termes. ils ont notamment permis de pénaliser les smoothing splines (limitant les risques d’over-fitting), et de stabiliser l’estimation des paramètres du terme ARMA.
Évaluation du modèle
Le modèle a fait l’objet d’une validation interne ayant notamment permis de valider les conditions d’application et sa capacité de prédiction.
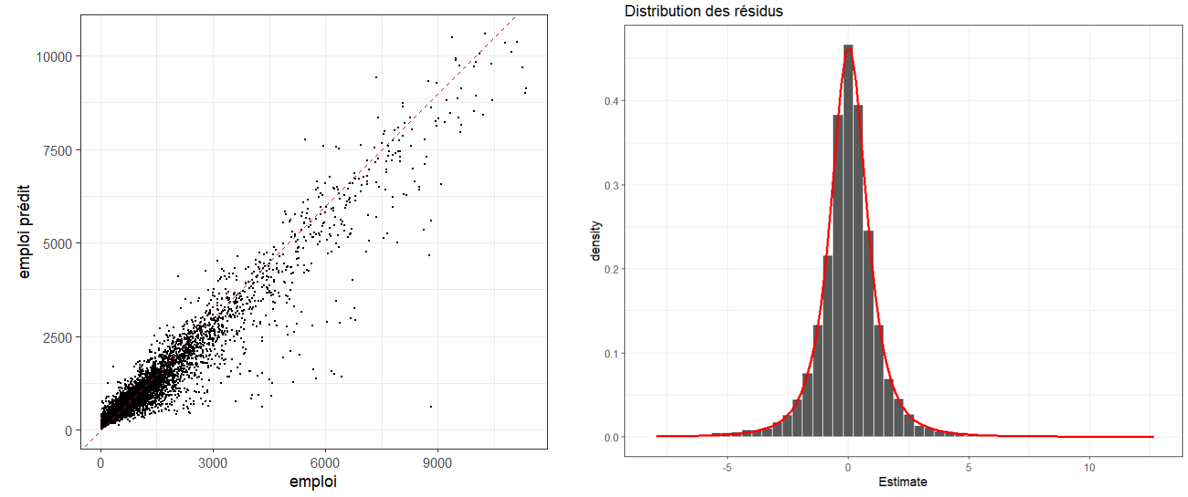
Le R2 du modèle est de 0,86, indiquant que près de 85% de la variance est expliquée par le modèle. Le modèle est capable de générer des données ayant une distribution comparable aux données originales et est caractérisé par des résidus suivants bien une distribution de Student.
Les résidus du modèle sont exempts de corrélation spatiale, cependant une autocorrélation temporelle négative dans les résidus a été observée. Cela signifie que si une année le modèle a tendance à surprédire l’emploi pour une ZAT, l’année suivant le modèle aura tendance à sous-prédire pour cette même ZAT. Considérant le faible nombre d’époques dans les données comparativement au nombre de ZAT, ce problème est mineur.
Nous avons également effectué un exercice de cross-validation en entraînant un modèle sans les données de 2016 et en prédisant l’emploi en 2016. Le RMSE du modèle complet est de 405, et le RMSE obtenu pour cet exercice de validation est de 390. Ce résultat indique une absence d’over-fitting temporel et laisse supposer que la qualité de prédiction pour les prochaines années sera similaire. Cette supposition repose sur l’hypothèse que la tendance temporelle de progression de l’emploi ne change pas abruptement.
Réalisation des projections
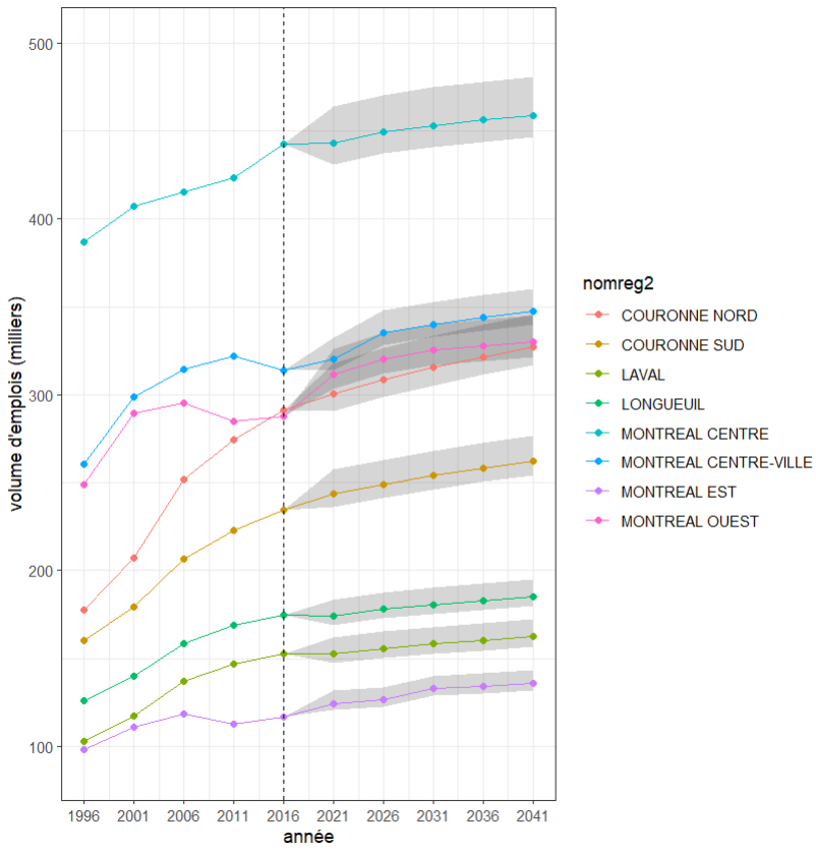
Les projections sont réalisées à partir du modèle en se basant sur la distribution postérieure de ces différents paramètres. Ainsi, chaque projection est caractérisée par une distribution complète. Cette distribution est ensuite transformée avec l’inverse de la transformation BoxCox pour obtenir une distribution des nombres d’emplois attendus.
Les projections sont réalisées en conservant statiques la plupart des effets fixes du modèle. En effet, nous ne disposons pas à l’ARTM de données sur la future occupation du sol. Ceci constitue une limite importante, car des grands développements commerciaux, industriels ou d’un autre type d’activité pourraient faire varier le nombre d’emplois futurs de façon importante. Cependant, si de telles données sont disponibles, il est possible de nous contacter pour que nous les intégrions directement dans les projections. Notez que le modèle fait aussi l’hypothèse de tendances stables, soit la continuité des tendances historiques. Il ne tient pas compte d’éventuels effets macroéconomiques (crises, politiques publiques, etc.)
Les projets majeurs de transport collectif (ligne bleue et REM) sont intégrés dans les projections. L’effet d’une station du REM a été codé comme équivalent à celui de la moitié d’une station de métro.
Pour la projection de chaque ZAT, trois valeurs sont rapportées : une estimation « centrale » (58e percentile), une estimation « basse » (55e percentile) et une estimation « élevée » (63e) percentile. Ces estimations ne sont pas centrées sur la vraie médiane (50e) percentile, car la distribution du nombre d’emplois est asymétrique.
Tableau 1 Volumes d'emplois projetés
| Année | Volume (1000) | Croiss. | Inter. Bas | Inter. Haut | |
| 1996 | 1 560 | -- | |||
| 2001 | 1 752 | 12.3% | |||
| 2006 | 1 900 | 8.4% | |||
| 2011 | 1 950 | 2.6% | |||
| 2016 | 2 014 | 3.3% | |||
| 2021 | 2071 | 2.8% | 2012 | 2175 | |
| 2026 | 2124 | 2.6% | 2064 | 2230 | |
| 2031 | 2160 | 1.7% | 2099 | 2268 | |
| 2036 | 2186 | 1.2% | 2124 | 2295 | |
| 2041 | 2210 | 1.1% | 2147 | 2320 |
Détail du jeu de données
Les données fournies sont composées de trois jeux de données :
- La géographie des ZAT (via un fichier GPKG)
- Les volumes d’emplois passés et projetés par ZAT (via un fichier CSV) avec les trois estimateurs mentionnés dans la section précédente. Le tableau suivant décrit les différentes colonnes de cette table.
| Colonne | Type | Interprétation |
| idzat | entier | Identifiant unique de chaque ZAT |
| AN | entier | Année |
| nb_emplois | numérique | Nombre d’emplois réel |
| pred_ nb_emplois_low | numérique | Nombre d’emploi projeté, valeur basse |
| pred_ nb_emplois_med | numérique | Nombre d’emploi projeté, valeur centrale |
| pred_ nb_emplois_high | numérique | Nombre d’emploi projeté, valeur élevée |
- 250 échantillons tirés de la distribution postérieure du modèle pour les projections par ZAT (via un fichier CSV). Ces échantillons permettent notamment de réaliser des exercices de propagation de l’incertitude de façon rigoureuse. Les colonnes s1 à s250 correspondent aux 250 valeurs d’échantillon pour chaque ZAT et chaque année de projection.
Certaines ZAT peuvent être manquantes dans les données de projection, ceci est dû à leur très petite taille qui posait des problèmes d’estimation dans le modèle. Nous laissons à l’utilisateur final le soin de compléter ces données manquantes par la méthode d’imputation de son choix.